Por qué la mayoría de los MVPs colapsan con tráfico real (y cómo solucionarlo)
Cuellos de botella en la base de datos, concurrencia mal manejada y costos fuera de control. Una guía técnica para auditar y blindar arquitecturas backend.
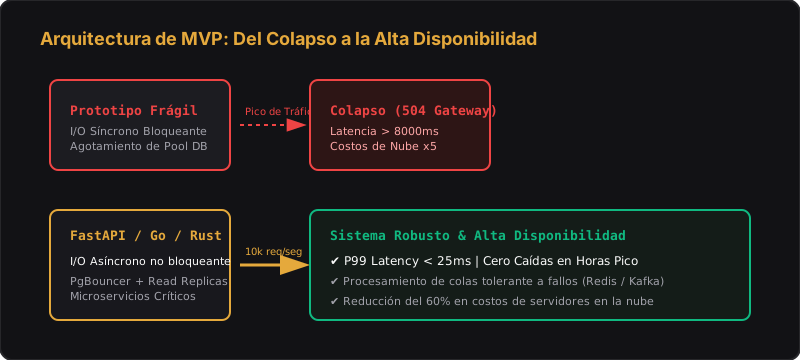
Construir un MVP rápido es el estándar para validar una idea de negocio. Sin embargo, cuando el producto consigue tracción real y miles de usuarios simultáneos acceden a la plataforma, las decisiones técnicas apresuradas pasan factura inmediata.
Los síntomas son conocidos: tiempos de respuesta que pasan de 80ms a más de 6 segundos, errores 504 Gateway Timeout, saturación del pool de conexiones en PostgreSQL y una factura de AWS/GCP que se multiplica sin justificación.
1. El mito del escalamiento vertical ciego
Cuando un sistema backend empieza a fallar bajo carga, la reacción común de muchos equipos es aumentar el tamaño de la instancia (de t3.medium a c6g.2xlarge).
Esto rara vez resuelve el problema de fondo. Si tu aplicación tiene bloqueos I/O en hilos de trabajo síncronos o no reutiliza conexiones a la base de datos, multiplicar los núcleos de CPU simplemente acelerará la saturación de conexiones hacia PostgreSQL o Redis.
Dónde se originan los cuellos de botella:
- Pool de conexiones agotado: Cada worker abre conexiones persistentes sin multiplexación (faltan herramientas como PgBouncer).
- Tareas pesadas en el ciclo de vida HTTP: Procesar imágenes, llamadas a APIs de IA o envío de emails directamente en el request handler en lugar de workers asíncronos.
- N+1 queries no detectadas: ORMs que ejecutan cientos de queries por cada fila renderizada.
2. Estrategia de Estabilización Técnica
Para blindar un sistema antes de una campaña masiva o ronda de inversión, el trabajo se estructura en tres capas:
graph LR
    A[Tráfico Concurrente] --> B[API Gateway / Nginx]
    B --> C[Backend FastAPI / Go]
    C -->|Connection Pool| D[(PgBouncer + Postgres)]
    C -->|Async Tasks| E[(Redis Queue)]
    E --> F[Worker Crítico en Rust]
Capa 1: Profiling Profundo y Observabilidad
Antes de reescribir una sola línea de código, instrumentamos trazas distribuidas (OpenTelemetry) y analizamos los flamegraphs de CPU y memoria.
Capa 2: Optimización del Backend en Python (FastAPI / Django)
Aplicamos diseño modular, tipado estricto con Pydantic v2, consultas SQL optimizadas con índices compuestos y desacoplamiento de tareas en segundo plano.
Capa 3: Microservicios Críticos en Rust y Go
Para los módulos donde la latencia P99 es crítica (motores de cálculo, ingesta de eventos o autenticación masiva), reescribimos el cuello de botella en Rust o Go.
// Ejemplo: Worker concurrente en Rust con procesamiento asíncrono
use tokio::sync::mpsc;

pub async fn procesar_eventos(mut rx: mpsc::Receiver<EventoMetrica>) {
    while let Some(evento) = rx.recv().await {
        tokio::spawn(async move {
            if let Err(e) = persistir_en_batch(evento).await {
                eprintln!("Fallo controlado de telemetría: {:?}", e);
            }
        });
    }
}
3. Blindando tu Arquitectura
Un MVP no necesita nacer con la complejidad de Netflix, pero sí requiere una arquitectura limpia, modular y con contratos de API bien delimitados para poder crecer sin reescribir todo desde cero.
Si estás preparando tu producto para un lanzamiento masivo o experimentando caídas intermitentes, auditar tu arquitectura a tiempo previene pérdidas de usuarios e inversión.
Fuentes Técnicas & Lecturas Recomendadas
- PostgreSQL Documentation: Connection Pooling and Resource Consumption[PostgreSQL Official Docs] ↗Sobrecarga de memoria por proceso worker de conexión y la necesidad crítica de multiplexación con PgBouncer.
- Tokio Runtime: Asynchronous Concurrency in Rust[Tokio Project] ↗Procesamiento asíncrono no bloqueante con bajo consumo de memoria y cero latencia de Garbage Collector.
- Martin Fowler: MonolithFirst & Microservice Boundaries[martinfowler.com] ↗Estrategias de desacoplamiento modular para evitar la complejidad distribuida prematura en startups.

Luis Guillermo Echenique
Senior Data Engineer & Cloud Solutions Architect · Remoto Internacional (Latam / Worldwide)
Especialista en sistemas distribuidos, arquitecturas Data Lakehouse e infraestructura de alta disponibilidad con más de 10 años de experiencia. Ha liderado migraciones críticas y optimización de pipelines de gran escala para organizaciones como Banco Transbank, Toyota Chile, Casaideas y Banco de Chile, gestionando volúmenes de telemetría y logs de hasta 10 GB/s.
Blindemos la estabilidad y escalabilidad de tu backend
Detecta fugas de memoria, reduce latencias P99 y optimiza el consumo de tus servidores con una auditoría técnica especializada.